
QualliScope Bardin
Protocolo completo para conduzir a Análise de Conteúdo de Bardin com apoio de Inteligência Artificial — da gravação e transcrição das entrevistas à auditoria metodológica final, com 20 passos guiados e estrutura zero prompt: os prompts já vêm embutidos na ferramenta.
As três fases clássicas de Bardin
O protocolo segue a estrutura clássica da Análise de Conteúdo, operacionalizada em 20 passos com alternância sistemática entre IA e validação humana.
1 · Pré-análise
Constituição do corpus, organização dos arquivos, transcrição, correção e leitura flutuante — humana e com IA.
2 · Exploração do material
Unidades de registro, codificação, auditoria dupla (IA + humana), codebook e categorização revisada.
3 · Tratamento, inferência e interpretação
Presença × ausência, relações entre categorias, inferências, diálogo com a literatura e auditoria final.
O protocolo em 20 passos
Da gravação da entrevista à auditoria metodológica final — cada passo indica quando a IA atua e quando a decisão é do pesquisador.
Fase 1 · Pré-análise
Preparação do corpus
Defina exatamente quais materiais serão analisados, respeitando exaustividade, representatividade, homogeneidade e pertinência.
Organização dos arquivos
Padronize os documentos (ex.: Entrevista 01 Q1 …) sem misturar entrevistas num único arquivo, preservando a origem de cada unidade de registro.
Transcrição dos áudios
Transcreva com IA generativa (ex.: Gemini) ou apps que gravam e transcrevem ao mesmo tempo — um arquivo por vez, por entrevistado.
Correção das transcrições
Leia cada transcrição acompanhando o áudio e ajuste manualmente o que a IA não transcreveu corretamente.
Leitura flutuante humana
O pesquisador lê todo o corpus e registra impressões iniciais: temas recorrentes e inesperados, contradições, opiniões e acontecimentos relevantes — sem criar categorias.
Leitura flutuante com IA
smart_toyPROMPT 1Segunda leitura exploratória com IA para auxiliar a familiarização com o corpus, identificando temas, percepções e possíveis relações.
Fase 2 · Exploração do material
Definição da unidade de registro
Estabeleça a unidade temática: fragmento da fala que contenha uma ideia, percepção, experiência ou significado relacionado ao objeto da pesquisa.
Codificação inicial com IA
smart_toyPROMPT 2A IA identifica as unidades de registro e atribui códigos descritivos com justificativa, em matriz: Entrevistado · Questão · Unidade de registro · Código · Justificativa — um entrevistado por vez.
Auditoria da codificação com IA
smart_toyPROMPT 3Auditoria crítica da codificação: relevância das unidades, fidelidade dos códigos, precisão, consistência e possíveis omissões. A IA sugere — não altera automaticamente.
Auditoria humana da codificação
Revisão manual: o trecho é relevante? O código representa a fala? Há códigos duplicados, genéricos ou específicos demais? O pesquisador decide e corrige na matriz.
Construção do codebook
Livro de códigos com definição, critérios de inclusão e exclusão e exemplos — torna a análise transparente e replicável.
Agrupamento em subcategorias e categorias
smart_toyPROMPT 4A IA agrupa códigos com relação temática em subcategorias e categorias, sem eliminar registros, diferenciando categorias a priori de emergentes.
Auditoria da categorização com IA
smart_toyPROMPT 5Auditoria da cadeia Código → Subcategoria → Categoria: coerência interna, redundância, sobreposição, justificativas e completude dos registros.
Auditoria humana da categorização
Validação humana final da estrutura categórica: fusões, separações e ajustes ficam a cargo do pesquisador.
Fase 3 · Tratamento dos resultados
Presença × Ausência
smart_toyPROMPT 6Análise das categorias quanto a frequência, alcance, presença/ausência, intensidade, contexto e diferenças entre entrevistados — sem tratar frequência como sinônimo de importância.
Relações entre categorias
smart_toyPROMPT 7Identificação de coocorrência, influência percebida, relação temporal, causa percebida, oposição e relações explicativas — sempre com evidências nos dados.
Inferências
smart_toyPROMPT 8Construção das inferências interpretativas vinculadas aos objetivos da pesquisa, classificadas como fortes, moderadas ou limitadas, com limites explícitos.
Fase 4 · Diálogo com a literatura
Preparação da literatura
Organize em uma pasta os artigos que fundamentaram o instrumento de pesquisa, identificados por autor e ano.
Diálogo resultados × literatura
smart_toyPROMPT 9Um artigo por vez: a IA confronta cada inferência com o conteúdo do artigo e classifica o diálogo como convergência, divergência, complementaridade ou aprofundamento.
Fase 5 · Auditoria final
Auditoria metodológica dos dados
smart_toyPROMPT 10A IA atua como auditora metodológica: verifica a rastreabilidade Corpus → Unidade de registro → Código → Categoria → Inferência e classifica cada achado (sem inconsistência, atenção, inconsistência, não sustentado).
Estrutura zero prompt
Os 10 prompts do protocolo já vêm embutidos na ferramenta — você não escreve nem copia nada. Cada um foi desenhado para uma etapa específica da análise.
Leitura flutuante
Visão geral do corpus: temas recorrentes e inesperados, percepções, contradições — sem categorizar.
Codificação inicial
Identifica unidades de registro e atribui códigos descritivos com justificativa em matriz estruturada.
Auditoria da codificação
Verifica relevância, fidelidade, precisão e consistência dos códigos — sugere, não altera.
Categorização
Agrupa códigos em subcategorias e categorias, distinguindo a priori de emergentes.
Auditoria da categorização
Audita Código → Subcategoria → Categoria: redundância, sobreposição e completude.
Presença × Ausência
Frequência, alcance, intensidade e contexto de cada categoria no corpus.
Relações entre categorias
Mapeia coocorrências, influências e contrastes sem transformar associação em causalidade.
Inferências
Interpretações ligadas aos objetivos, com grau de sustentação e limites explícitos.
Diálogo com a literatura
Confronta inferências com cada artigo: convergência, divergência, complementaridade.
Auditoria final
Rastreabilidade completa da análise e classificação de inconsistências para decisão do pesquisador.
A IA sugere. O pesquisador decide.
O protocolo atribui à IA funções analíticas concretas, mas mantém todas as decisões metodológicas, analíticas e interpretativas sob responsabilidade do pesquisador.
O que a IA faz
- checkTranscreve os áudios das entrevistas
- checkRealiza a segunda leitura flutuante do corpus
- checkIdentifica unidades de registro e sugere códigos
- checkAudita codificação e categorização
- checkAgrupa códigos em subcategorias e categorias
- checkCalcula frequência, alcance e presença/ausência
- checkMapeia relações entre categorias
- checkApoia a construção das inferências
- checkDialoga os resultados com a literatura
- checkAudita a rastreabilidade de todo o processo
O que o pesquisador decide
- checkDefine o corpus e a unidade de registro
- checkCorrige manualmente as transcrições
- checkFaz a primeira leitura flutuante
- checkValida e decide sobre cada código
- checkDecide sobre fusões e ajustes de categorias
- checkInterpreta os resultados tratados
- checkConstrói e valida as inferências finais
- checkConduz a discussão científica
- checkDecide em todos os pontos de auditoria
- checkResponde pela responsabilidade científica
IA = apoio, sugestão, organização, identificação, cálculo, comparação e auditoria.
Pesquisador = definição, julgamento, validação, decisão, interpretação e responsabilidade científica.
Por que System One Models são mais promissoras para a ciência?
O QualliScope Bardin combina o melhor de cada tecnologia: o LLM gera texto e interpretações; o SOM decide com precisão tipada e auditável.
Para professores e pesquisadores de ensino superior, o grande desafio dos LLMs, SLMs e OLMs na análise qualitativa não é a fluência textual — é a falta de garantia. Modelos generativos produzem respostas plausíveis, mas podem alucinar códigos, confundir unidades e mascarar incerteza com frases convincentes.
O System One Model (SOM), usado pelo motor Jev, muda essa lógica: em vez de texto livre, ele responde perguntas tipadas com probabilidades calibradas. Para cada unidade de registro, o SOM avalia critérios metodológicos explícitos — relevância, fidelidade, granularidade, duplicidade, múltipla codificação — e entrega uma decisão com escore de confiança.
No modo cascata, o SOM decide e o LLM escreve a justificativa. O pesquisador mantém a decisão final, mas a triagem direciona a atenção humana apenas para as linhas de baixa confiança ou com flags.
Vantagens para a pesquisa qualitativa
- check_circleDecisões estruturadas, não texto solto: cada avaliação segue critérios metodológicos explícitos.
- check_circleCalibração: probabilidades e confiança mostram onde o modelo tem certeza e onde duvida.
- check_circleTriagem inteligente: só as linhas de baixa confiança ou flags exigem revisão humana.
- check_circleTransparência científica: o pesquisador pode auditar cada decisão por critério.
- check_circleModo cascata: SOM decide com precisão, LLM justifica com fluência.
- check_circleMenor custo cognitivo: menos tempo lendo justificativas longas; foco nas exceções.
Espera-se maior consistência entre codificadores, redução do tempo de auditoria humana, menor risco de alucinações e um corpus mais robusto para publicação.
Como o Jev decide — playground do método científico
Assim como um experimento bem desenhado define variáveis, critérios e medições, o motor Jev avalia cada unidade de registro por perguntas tipadas com probabilidades calibradas.
Onde os LLMs geram texto livre — e podem inventar justificativas convincentes — o SOM responde dentro de estruturas pré-definidas, tornando a decisão transparente, mensurável e replicável.
State · contexto
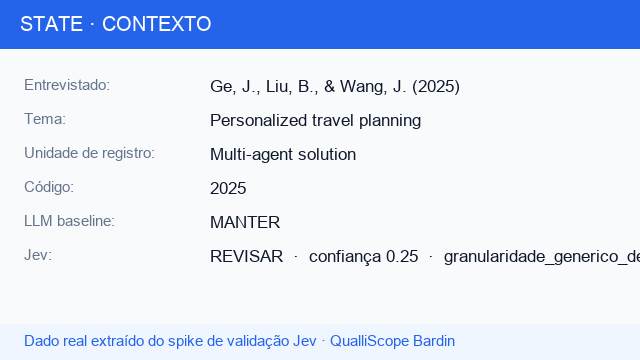
Caso real do spike de validação
Questions · critérios tipados
- 1[Score] relevancia — A unidade de registro trata do objeto de pesquisa?
- 2[Score] fidelidade — O código representa com fidelidade o conteúdo da unidade?
- 3[Choice] granularidade — O código está em nível adequado: genérico, adequado ou específico demais?
- 4[Choice] duplicado — Há código sinônimo ou duplicado na mesma linha?
- 5[Noul] multiplica — A unidade legitima mais de um código?
- 6[Choice] decisao — Dado tudo, a recomendação é MANTER, REVISAR, ALTERAR ou EXCLUIR?
Answers · decisão estruturada
Decisão final: REVISAR — a unidade 'Multi-agent solution' foi considerada genérica demais. O LLM aprovou (MANTER), mas o Jev sinalizou que o código precisa ser detalhado antes de seguir na matriz.
Jev vs LLM — resultado em dados reais
Spike com 31 registros de uma auditoria real do passo 9. O SOM se mostrou muito mais crítico que o LLM generativo anterior.
Ainda não há análises contribuídas. O spike piloto abaixo mostra o potencial do modelo.
6.5%
Concordância LLM × Jev
0.0
Cohen's κ
28 / 31
Linhas sinalizadas
US$ 0.005
Custo estimado
0.048 s/linha
Latência média
129.278
Tokens de entrada
Decisões do LLM
MANTER
Decisões do Jev
REV = REVISAR · MANT = MANTER · EXC = EXCLUIR
Enquanto o LLM aprovou todas as unidades, o Jev indicou revisão ou exclusão em 29 casos. Isso demonstra que o SOM pode reduzir a dependência de justificativas genéricas e direcionar a revisão humana para onde há de fato problema metodológico.
Contribua com estatísticas anônimas
Com seu consentimento, o QualliScope pode enviar métricas agregadas (decisões finais, flags e confianças) de seus projetos para uma base de benchmark. Nenhum texto bruto, entrevista ou identificação é compartilhado. O objetivo é calibrar thresholds e modelos ao longo do tempo com dados reais.
Saiba mais nas Configurações do app
Formulação metodológica recomendada
Texto sugerido para descrever o uso da IA na seção de metodologia do seu trabalho.
“A Análise de Conteúdo foi conduzida pelo pesquisador segundo o protocolo fundamentado em Bardin, com utilização de Inteligência Artificial como ferramenta de apoio em diferentes etapas do processo. A IA foi empregada na transcrição, leitura flutuante complementar, identificação de unidades de registro, codificação inicial, auditoria da codificação, organização dos códigos, categorização, auditoria da categorização, tratamento dos resultados, identificação de relações, apoio à construção de inferências, diálogo com a literatura e auditoria final. As decisões metodológicas e analíticas, bem como a validação das unidades de registro, códigos, subcategorias, categorias, relações, inferências e interpretações, permaneceram sob responsabilidade do pesquisador.”
Baixe o QualliScope Systen
Ferramenta Python local com estrutura zero prompt: executa os 20 passos do protocolo de ponta a ponta — codificação, categorização, auditorias e inferências — sem você escrever um único prompt.
Instalador standalone para macOS e Windows — não requer Python · conta Science Editor gratuita · IA local (Ollama), sua própria chave (BYOK) ou IA gerenciada inclusa no plano Pesquisador Pro
O botão detecta automaticamente o seu sistema operacional. O app roda 100% local e ajuda a instalar o Ollama se você optar por IA local.
Análise qualitativa com rigor e rastreabilidade
Baixe a ferramenta e conduza sua Análise de Conteúdo de Bardin com auditabilidade de ponta a ponta — automatizada pela estrutura zero prompt.
Perguntas sobre o Science Editor
Para quem é o Science Editor?
O Science Editor reúne ferramentas para autores, pesquisadores e equipes editoriais. A plataforma apoia a validação de artigos conforme as normas cadastradas dos periódicos e a organização de fluxos acadêmicos.
A validação substitui a avaliação científica?
Não. A verificação de formatação e conformidade apoia a preparação do manuscrito. A avaliação do conteúdo científico e a decisão de publicação continuam com os responsáveis pelo periódico.
O que é o QualliScope Systen?
É a frente de análise qualitativa do ecossistema, com um fluxo guiado para análise de conteúdo e revisão metodológica pelo pesquisador. A inteligência artificial apoia o trabalho; a interpretação e a revisão continuam sob responsabilidade humana.